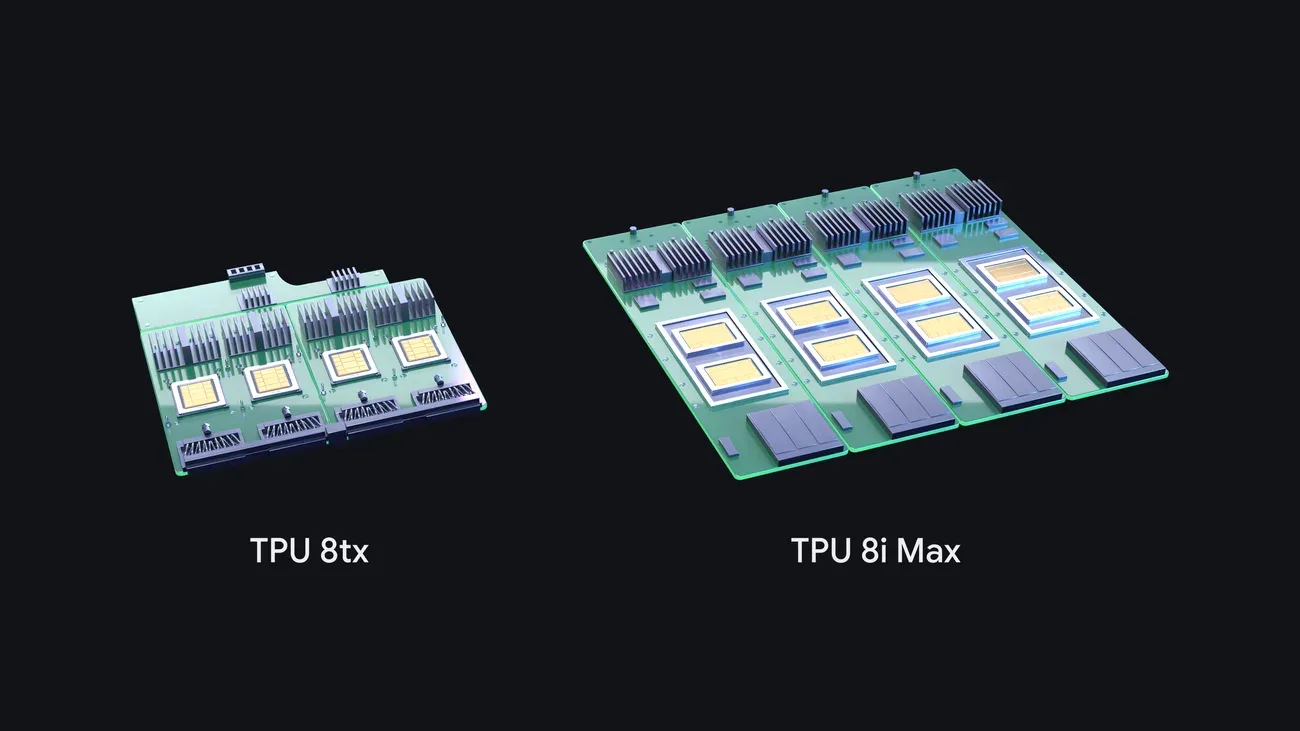
Google anunció este 9 de noviembre de 2026 TPU 8tx y TPU 8i Max, dos sistemas para ejecutar IA con datos sensibles o ventanas de contexto enormes. Según el anuncio de Google, se integran a su octava generación de TPU, que por primera vez suma cuatro sistemas presentados en un mismo año.
Al reproducir se carga el video desde YouTube (modo de privacidad mejorada) y aplican sus políticas.
O verlo en YouTube⚙️ La familia arrancó en Google Cloud Next, en abril, con TPU 8t para entrenamiento a gran escala y TPU 8i para razonamiento en tiempo real. Frente a la generación anterior, Google atribuye a 8t hasta 2.7 veces el rendimiento de entrenamiento y a 8i una mejora de 80% en la relación precio-rendimiento de inferencia. La primera prioriza el trabajo útil por watt; la segunda reduce hasta a la mitad los retrasos de comunicación entre chips.
🔒 TPU 8tx busca proteger los datos y los pesos del modelo incluso mientras se procesan, con aislamiento y seguridad en hardware para empresas reguladas y gobiernos. Utiliza el mismo silicio de TPU 8t, servidores anfitriones con CPU AMD EPYC de quinta generación y la red de baja latencia Boardfly; Google reporta hasta la mitad de latencia frente a 8t, con una penalización de rendimiento prácticamente nula por la protección. Además de inferencia confidencial, permite entrenamiento a pequeña escala, ajuste con datos privados, destilación y aprendizaje por refuerzo sin trasladar información sensible entre clústeres separados.
🧠 TPU 8i Max combina dos chips TPU 8i en un solo encapsulado para atender ventanas de contexto a escala de millones de tokens. Según Google, duplica el cómputo, la SRAM y el ancho de banda de memoria HBM frente a 8i, además de colocar el doble de silicio en el mismo espacio de rack. La idea es evitar que el acceso a memoria frene a grupos de agentes que revisan repositorios completos o varias horas de video, y aumentar el cómputo disponible por superficie y por watt.
🛠️ Ojo con la diferencia: son nuevos sistemas, no una nueva generación de chips. Google reorganiza cómputo, memoria, redes, almacenamiento y seguridad alrededor del silicio existente mediante el diseño modular de su AI Hypercomputer, una estrategia que, asegura, permite preparar configuraciones especializadas en meses en lugar de años. La compañía codiseña sus TPU con Google DeepMind y ahora incorpora más comentarios de organizaciones externas sobre contexto extenso y cifrado especializado.
¿Qué cambia para quienes desarrollan con IA?
La apuesta es elegir infraestructura según el problema: entrenar modelos grandes, responder con poca latencia, trabajar con información confidencial o procesar contextos enormes. Google empezó a diseñar TPU hace más de una década para tareas internas como reconocimiento de voz y traducción; hoy las usa para entrenar y servir Gemini, ejecutar agentes y atender a casi 100 clientes —desde laboratorios y firmas de trading hasta comercios y universidades—, incluso con despliegues en centros de datos propios de clientes. Para facilitar su adopción, la empresa también destaca soporte para PyTorch, software de código abierto y herramientas automatizadas, aunque no detalla precios ni fechas de disponibilidad para los dos nuevos sistemas.
💬 Si tuvieras que llevar un agente a producción, ¿qué te limitaría primero: proteger los datos mientras se procesan o darle contexto suficiente para revisar todo tu repositorio?
¿Pero deveras? 🌵💚